فهرست مقاله
در یک سامانهٔ پایش جریان الکتریکی، داشتن حلقهای که بدون خطا اجرا شود کافی نیست. باید بدانیم آخرین نمونهها واقعاً مصرف شدهاند، گذر دوم روی داده چه معنایی دارد و تغییر اندازهٔ دسته، محاسبهٔ آماری را عوض نمیکند. این آموزش با ده نمونهٔ مصنوعی، خطاهایی را آشکار میکند که ممکن است پیش از ورود داده به مدل هوش مصنوعی پنهان بمانند. مثال آموزشی است؛ هیچ حسگر واقعی، سرعت شبکه یا کیفیت مدل در آن اندازهگیری نشده است.
۱. قرارداد داده: هر نمونه یک زمان و یک جریان
ورودی را زوج مرتب زمان بر حسب ثانیه و جریان بر حسب آمپر میگیریم. فاصلهٔ نمونههای مصنوعی ۱۰ میلیثانیه است؛ زمانها از صفر تا ۹۰ میلیثانیه میرسند. از این قرارداد نباید مدت روشن بودن دستگاه یا نرخ انتقال شبکه را نتیجه گرفت. مقادیر جریان در کد ثابتاند تا هر خواننده بتواند همان محاسبه را تکرار کند. دو مقدار بزرگ انتهایی عمداً انتخاب شدهاند تا گم شدن آخرین دسته در میانگین دیده شود؛ نشانهٔ خرابی یک تجهیز واقعی نیستند.
تابع sensor_source با هر بار فراخوانی یک مولد تازه میسازد. دستور yield رکورد را تحویل میدهد و وضعیت اجرای تابع را تا درخواست بعدی نگه میدارد؛ مبنای این رفتار در آموزش رسمی مولدهای پایتون توضیح داده شده است. در این مثال، داده محدود و از قبل معلوم است؛ وصل کردن همین الگو به سوکت، بهتنهایی مدیریت قطع ارتباط و فشار ورودی را حل نمیکند.
اعتبارسنجی ما متناهی بودن هر دو مقدار و افزایش سختگیرانهٔ زمان را میسنجد. بنابراین زمان تکراری و NaN رد میشوند. این کنترل، تنبل است: ساختن مولد به معنی بررسی تمام رکوردهای آینده نیست. خطای یک رکورد دیررس ممکن است پس از مصرف رکوردهای سالم قبلی رخ دهد. برای ذخیرهسازی اتمی، به قرارداد جداگانهای مانند آزمون تراکنش دادهٔ حسگر در SQLite نیاز داریم.
۲. آخرین دسته و دام مصرف دوبارهٔ مولد
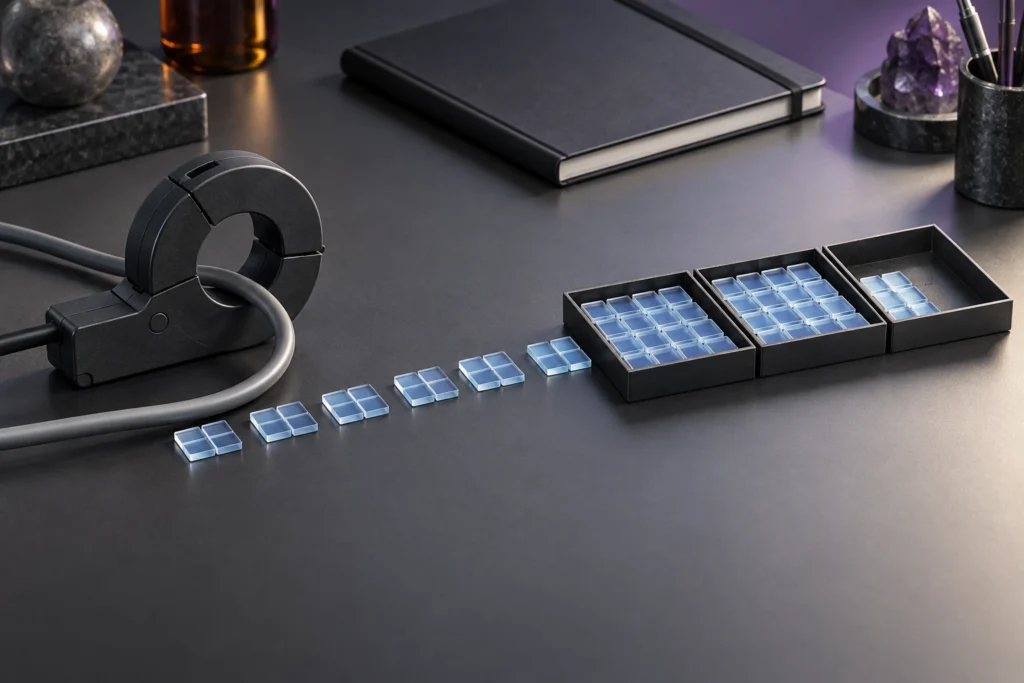
برای اندازهٔ دستهٔ چهار، ده رکورد به گروههای ۴، ۴ و ۲ تقسیم میشوند. در مستندات itertools.batched، حالت معمول آخرین گروه کوتاهتر را نگه میدارد. گزینهٔ strict=True در صورت کوتاه بودن آن خطا میدهد؛ روش حذف بیصدای انتهای داده نیست. تابع batched از پایتون ۳٫۱۲ و گزینهٔ strict از ۳٫۱۳ در دسترس است؛ کد حاضر با پایتون ۳٫۱۴٫۵ اجرا شده است.
اندازهٔ دسته باید مثبت باشد. انتخاب چهار در اینجا برای نمایش خطا مناسب است، نه توصیهای برای همهٔ کاربردها. اندازهٔ واقعی به هزینهٔ هر رکورد، تأخیر مجاز و محدودیت حافظه وابسته است. آزمون ما تنها نشان میدهد درخواست نخستین دسته، چهار رکورد از منبع نمونه مصرف کرده است؛ اندازهٔ بافر درایور، سیستمعامل یا حسگر را اندازه نمیگیرد.
مولد مصرفشده به ابتدای داده برنمیگردد. در آزمون، شمارش گذر اول ده و گذر دوم روی همان شیء صفر است. راهحل این منبع محدود، فراخوانی دوبارهٔ کارخانهٔ sensor_source() است. در دریافت زنده، ایجاد شیء تازه الزاماً گذشته را بازپخش نمیکند؛ برای بازتولید باید داده را ثبت و سیاست بازخوانی تعریف کرد. چارچوب آزمایش تکرارپذیر سیگنال در پایتون به ثبت ورودی و تنظیمات کمک میکند.
۳. کد کامل و چهارده آزمون قابل اجرا
کد زیر فقط از کتابخانهٔ استاندارد استفاده میکند. آن را در فایل sensor_generator.py ذخیره و با python sensor_generator.py اجرا کنید. تابع summarize هر رکورد را دقیقاً یک بار وارد محاسبه میکند. پس از افزایش شمارنده، اختلاف مقدار جدید با میانگین قبلی محاسبه میشود؛ میانگین با سهم یکبرشمارنده اصلاح و مجموع انحرافهای اصلاحشده در m2 جمع میشود. در انتها تقسیم بر تعداد، واریانس جامعهٔ همین ده مقدار را میدهد.
"""Authored finite sensor-stream example; no hardware or ML training benchmark."""
from itertools import batched
import json
import math
import platform
import statistics


VALUES_A = (0.10, 0.12, 0.14, 0.16, 0.18, 0.20, 0.22, 0.24, 0.80, 0.90)


def sensor_source(values=VALUES_A):
    for index, current_a in enumerate(values):
        yield index * 0.01, current_a  # seconds, amperes; synthetic only


def validated_rows(source):
    previous = -math.inf
    for time_s, current_a in source:
        time_s, current_a = float(time_s), float(current_a)
        if not math.isfinite(time_s) or not math.isfinite(current_a):
            raise ValueError("Non-finite sensor value")
        if time_s <= previous:
            raise ValueError("Time must increase strictly")
        previous = time_s
        yield time_s, current_a


def summarize(source, size):
    count, mean, m2 = 0, 0.0, 0.0
    for batch in batched(validated_rows(source), size, strict=False):
        for _, current_a in batch:
            count += 1
            delta = current_a - mean
            mean += delta / count
            m2 += delta * (current_a - mean)
    if count == 0:
        raise ValueError("No samples to summarize")
    return {"count": count, "mean_a": mean, "population_variance_a2": m2 / count}


def rejects(call):
    try:
        call()
    except ValueError:
        return True
    return False


def run_example():
    result = summarize(sensor_source(), 4)
    groups = list(batched(validated_rows(sensor_source()), 4))
    naive_mean = statistics.fmean(statistics.fmean(r[1] for r in batch) for batch in groups)
    source = validated_rows(sensor_source())
    first_pass = sum(1 for _ in source)
    second_pass = sum(1 for _ in source)
    pulled = []

    def observed_source():
        for record in sensor_source():
            pulled.append(record)
            yield record

    first_batch = next(batched(validated_rows(observed_source()), 4))
    variants = [summarize(sensor_source(), size) for size in (1, 3, 4, 7, 20)]
    checks = {
        "all_samples_preserved": [row for group in groups for row in group] == list(sensor_source()),
        "last_batch_is_partial": [len(group) for group in groups] == [4, 4, 2],
        "mean_matches_independent_reference": math.isclose(result["mean_a"], statistics.fmean(VALUES_A)),
        "variance_matches_independent_reference": math.isclose(result["population_variance_a2"], statistics.pvariance(VALUES_A)),
        "changing_batch_size_preserves_statistics": all(x["count"] == 10 and math.isclose(x["mean_a"], result["mean_a"]) and math.isclose(x["population_variance_a2"], result["population_variance_a2"]) for x in variants),
        "unweighted_batch_means_are_biased_here": not math.isclose(naive_mean, result["mean_a"]),
        "consumed_generator_stays_exhausted": first_pass == 10 and second_pass == 0,
        "factory_recreates_finite_source": summarize(sensor_source(), 4) == result,
        "first_batch_pulls_only_four_records": len(first_batch) == 4 and len(pulled) == 4,
        "nonfinite_record_rejected": rejects(lambda: summarize(sensor_source((0.1, float("nan"))), 4)),
        "duplicate_timestamp_rejected": rejects(lambda: summarize(iter([(0.0, 0.1), (0.0, 0.2)]), 4)),
        "invalid_batch_size_rejected": rejects(lambda: summarize(sensor_source(), 0)),
        "empty_source_rejected": rejects(lambda: summarize(iter(()), 4)),
        "strict_mode_reports_short_final_batch": rejects(lambda: list(batched(sensor_source(), 4, strict=True))),
    }
    assert all(checks.values()), checks
    return {"python": platform.python_version(), "synthetic_only": True,
            "sample_interval_seconds": 0.01, "last_timestamp_seconds": 0.09,
            "batch_lengths": [len(group) for group in groups],
            "summary": result, "incorrect_unweighted_mean_a": naive_mean,
            "batch_sizes_checked": [1, 3, 4, 7, 20], "checks": checks}


if __name__ == "__main__":
    print(json.dumps(run_example(), indent=2))
آزمونها پوشش همهٔ نمونهها، کوتاهی گروه آخر، تطبیق میانگین و واریانس با مرجع مستقل، ثبات نتیجه با پنج اندازهٔ دسته، خطای میانگینگیری نادرست، پایان مولد و ساخت مجدد منبع را میسنجند. مصرف چهار رکورد در درخواست نخست، رد مقدار نامتناهی، زمان تکراری، اندازهٔ صفر، ورودی خالی و خطای strict نیز بررسی شدهاند. موفقیت این چهارده بررسی، پوشش همهٔ خطاهای ممکن یک سامانهٔ صنعتی را اثبات نمیکند.
برای مقایسهٔ مستقل از توابع fmean و pvariance در statistics استفاده میشود. فهرستسازی در بخش آزمون فقط برای ده رکورد معلوم است؛ آن را با مسیر تجمیع جریانی اشتباه نگیرید. برابری عدد اعشاری با تلورانس بررسی میشود، زیرا نمایش دودویی لزوماً رشتهٔ کوتاه اعشاری تولید نمیکند.
۴. خواندن خروجی و پیدا کردن میانگین اشتباه
در اجرای ثبتشده، تعداد ده، میانگین جریان ۰٫۳۰۶ آمپر و واریانس جامعه ۰٫۰۷۶۱۶۴ آمپر مربع است. میانگین گروهها به ترتیب ۰٫۱۳، ۰٫۲۱ و ۰٫۸۵ آمپر میشود. میانگین سادهٔ این سه عدد حدود ۰٫۳۹۶۶۶۷ است و پاسخ درست نیست، چون به دستهٔ دو عضوی همان وزن دستهٔ چهار عضوی را دادهایم. محاسبهٔ صحیح از مجموع ۴×۰٫۱۳، ۴×۰٫۲۱ و ۲×۰٫۸۵، تقسیم بر ده به دست میآید.
{
  "python": "3.14.5",
  "synthetic_only": true,
  "sample_interval_seconds": 0.01,
  "last_timestamp_seconds": 0.09,
  "batch_lengths": [
    4,
    4,
    2
  ],
  "summary": {
    "count": 10,
    "mean_a": 0.30600000000000005,
    "population_variance_a2": 0.076164
  },
  "incorrect_unweighted_mean_a": 0.3966666666666667,
  "batch_sizes_checked": [
    1,
    3,
    4,
    7,
    20
  ],
  "checks": {
    "all_samples_preserved": true,
    "last_batch_is_partial": true,
    "mean_matches_independent_reference": true,
    "variance_matches_independent_reference": true,
    "changing_batch_size_preserves_statistics": true,
    "unweighted_batch_means_are_biased_here": true,
    "consumed_generator_stays_exhausted": true,
    "factory_recreates_finite_source": true,
    "first_batch_pulls_only_four_records": true,
    "nonfinite_record_rejected": true,
    "duplicate_timestamp_rejected": true,
    "invalid_batch_size_rejected": true,
    "empty_source_rejected": true,
    "strict_mode_reports_short_final_batch": true
  }
}اندازههای یک، سه، چهار، هفت و بیست در این اجرا آمار یکسانی ساختهاند، زیرا ترتیب و اعضای داده حفظ شده و فرمول به مرز دسته وابسته نیست. این نتیجه دربارهٔ آموزش شبکهٔ عصبی تعمیم ندارد؛ تغییر batch size میتواند مسیر بهینهسازی مدل را عوض کند. در اینجا نه مدل آموزش دادهایم و نه تصادفیسازی، زمان اجرا یا مصرف حافظه را سنجیدهایم.
برای رکوردهای هماندازه، مسیر summarize یک دسته و چند متغیر عددی نگه میدارد؛ حافظهٔ دسته با اندازهٔ آن رشد میکند. منبع بالادست ممکن است بافر دیگری داشته باشد و مجموعهٔ آزمون نیز عمداً دادهٔ کوچک را فهرست میکند. پس ادعای حافظهٔ ثابت برای کل برنامه یا صرفهجویی اندازهگیریشده نداریم. واحد واریانس آمپر مربع است؛ برای واریانس نمونه باید قرارداد و مخرج دیگری انتخاب شود، نه اینکه نام خروجی فعلی تغییر کند.
۵. تمرینهای پاسخدار و مرز ورود به یادگیری ماشین
تمرین اول: با اندازهٔ سه، طول دستهها چیست؟ پاسخ: سه، سه، سه و یک؛ هر ده رکورد باید باقی بماند. حذف گروه آخر هم تعداد و هم محاسبه را عوض میکند. تمرین دوم: آیا strict مانع هر خروجی ناقص در کل فرایند میشود؟ پاسخ: فقط کوتاهی دستهٔ آخر را خطا میکند؛ گروههای کامل قبلی ممکن است پیشتر تحویل شده باشند، پس جای تراکنش یا برگشت عملیات را نمیگیرد.
تمرین سوم: چرا گذر دوم خالی است؟ پاسخ: همان شیء تا پایان مصرف شده؛ برای دادهٔ مصنوعی تابع منبع را دوباره فراخوانی کنید. تمرین چهارم: آیا منبعی با زمان برابر پذیرفته میشود؟ پاسخ: در قرارداد این آموزش خیر؛ رکورد دوم خطا میدهد. اگر چند کانال زمان یکسان دارند، باید شناسهٔ کانال و قانون ترتیب را صریحاً اضافه کرد، نه اینکه آزمون را بیدلیل خاموش کنیم.
برای گسترش به یادگیری ماشین، راهنمای IterableDataset در PyTorch 2.14 را جداگانه بخوانید. چند worker میتوانند نسخههای منبع را تکرار کنند؛ تقسیم ورودی باید آگاهانه طراحی شود. در منبع تکرارپذیرِ چندکارگری، drop_last دستهٔ ناقص هر نسخهٔ worker را حذف میکند و معادل strict نیست. این مقاله تقسیم بین کارگرها را پیاده نکرده است. ابتدا پوشش رکورد و آمار را تثبیت کنید، سپس معیارهای اختصاصی مدل را بیفزایید؛ تاریخ دسترسی منابع ۲۳ مهر ۱۴۰۵ است و این مطلب خبر پژوهشی تازه محسوب نمیشود.
منابع و مطالعهٔ بیشتر
- دستهبندی تنبل با itertools.batched در Python 3.14
- تکرارگر و مولد در آموزش رسمی Python 3.14
- IterableDataset و چندپردازشی در PyTorch 2.14
- میانگین و واریانس جامعه در کتابخانهٔ statistics
بررسی منابع: ۲۳ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.