فهرست مقاله
وقتی یک فیلتر، الگوریتم تشخیص عیب یا مدل هوش مصنوعی نتیجهٔ مناسبی میدهد، پرسش بعدی این است: آیا مهندس دیگری میتواند همان آزمایش را بازسازی و علت نتیجه را بررسی کند؟ داشتن تصویر نمودار یا یک عدد خطا کافی نیست. ورودی، تنظیمات، نسخهٔ کد و روش محاسبهٔ معیار باید مشخص باشند. در این آموزش، یک آزمایش تألیفی با سیگنال مصنوعی میسازیم و تفاوت «اجرای دوبارهٔ یک آزمایش» با «آزمایش مستقل روی دادهٔ تازه» را روشن میکنیم. مثال با پایتون اجرا شده است؛ هیچ دادهٔ اندازهگیری موتور یا نتیجهٔ عملکرد محصولی در آن وجود ندارد.
۱. ابتدا مشخص کنید چه چیزی باید تکرار شود
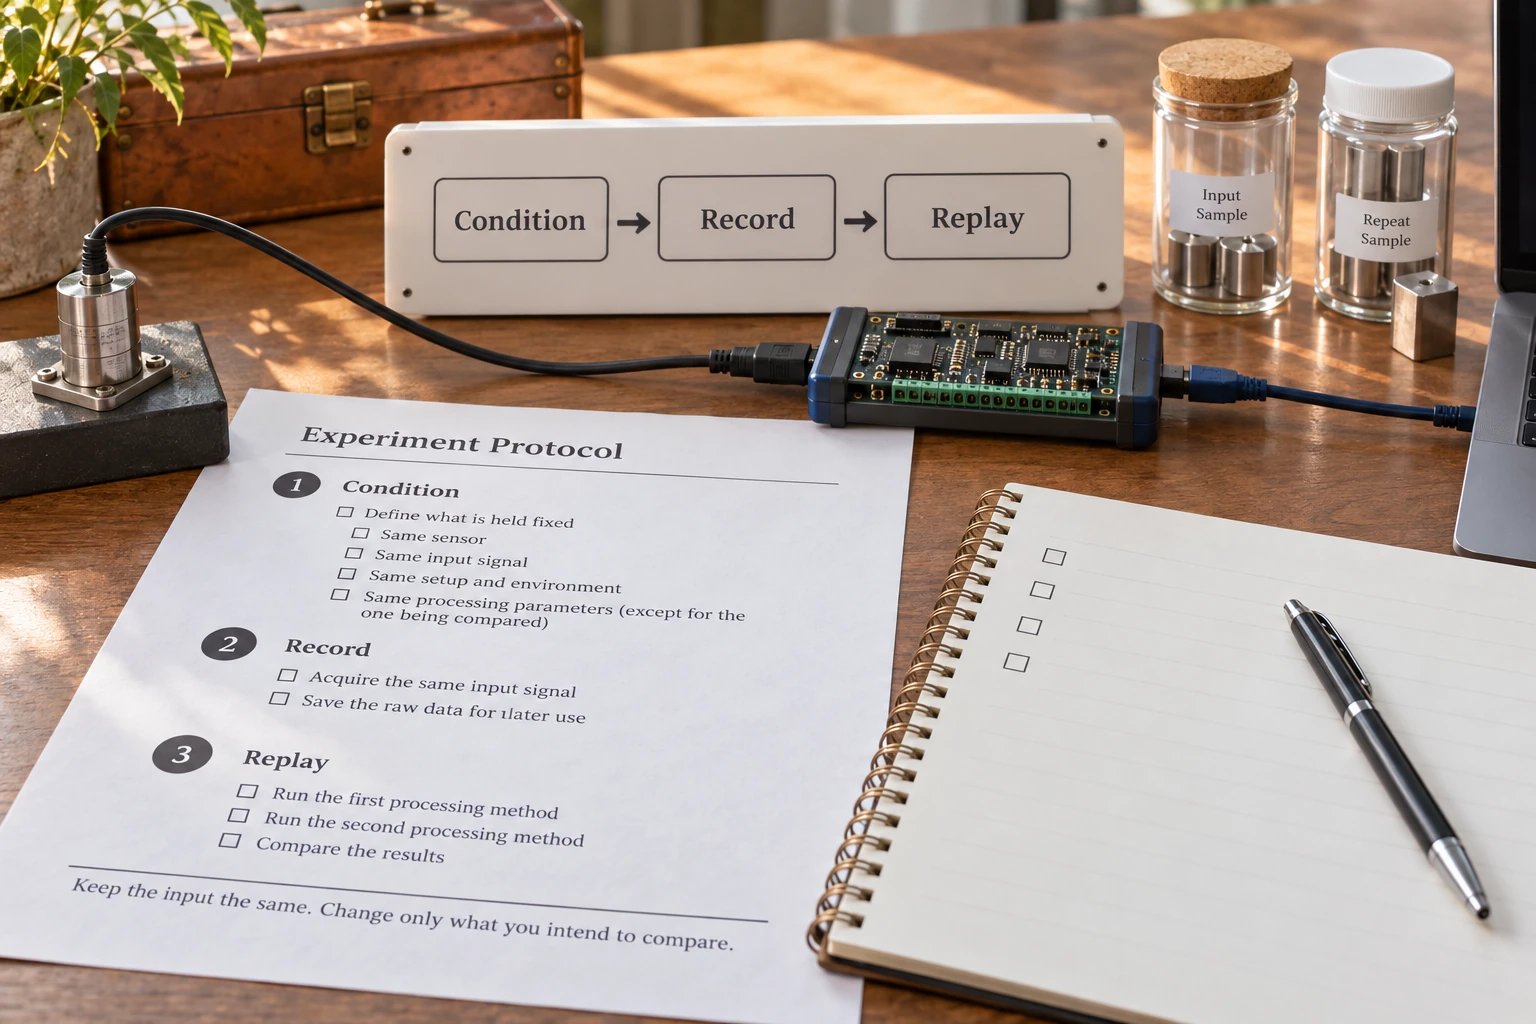
یک پروتکل کوتاه بنویسید: ورودی چیست، چه عملیاتی انجام میشود و معیار خروجی چگونه محاسبه میشود؟ برای مثال حاضر، ورودی یک سیگنال دوثانیهای با نرخ نمونهبرداری ۲۰۰۰ نمونه در ثانیه است. مؤلفهٔ مطلوب یک موج ۱۰۰ هرتز است؛ موج مزاحم ۷۰۰ هرتز و اغتشاش تصادفی به آن افزوده میشوند. دامنهها واحد فیزیکی ندارند و صرفاً آموزشی هستند. هدف آزمایش، بررسی ثبت و بازسازی یک مسیر پردازش است.
دو نوع مقایسه را جدا نگه دارید. در اجرای دوباره، داده و تنظیمات یکساناند و میخواهیم نتیجه در همین محیط محاسباتی تکرار شود. در مقایسهٔ دو تنظیم، ورودی را ثابت نگه میداریم و فقط یک پارامتر را تغییر میدهیم. در ارزیابی تعمیم، دادهٔ تازه لازم است؛ تکرار یک ورودی ثابت نمیتواند نشان دهد الگوریتم برای موتور دیگر، حسگر دیگر یا شرایط محیطی متفاوت نیز مناسب است.
پیش از اجرا، معیار پذیرش را مشخص کنید. در این مثال، شکل خروجی باید حفظ شود، تمام مقادیر متناهی باشند و اجرای دوبارهٔ همان مسیر در همان محیط نتیجهٔ یکسان بدهد. معیار خطا، جذر میانگین مربع اختلاف خروجی با مرجع مصنوعی است. صد نمونه از هر انتها برای محاسبهٔ معیار کنار گذاشته میشود؛ این انتخاب بخشی از پروتکل است و نباید پس از دیدن نتیجه، بدون ثبت تغییر کند. چنین قراردادی یکی از گامهای تبدیل نمونهٔ اولیه به سامانهٔ قابل اتکا است.
۲. بذر تصادفی را با نسخهٔ داده اشتباه نگیرید
طبق سیاست سازگاری مولد تصادفی NumPy، بازسازی جریان تصادفی به مجموعهای از شرایط وابسته است: مولد، بذر، ترتیب فراخوانیها، آرگومانها و محیط اجرا. بنابراین نوشتن یک عدد بهعنوان seed، ثبت کامل آزمایش نیست. افزودن یک فراخوانی تصادفی پیش از ساخت اغتشاش، حتی با همان بذر، مسیر مصرف اعداد را تغییر میدهد؛ این حالت را در کد عمداً بررسی میکنیم.
در مثال، PCG64 بهصورت صریح انتخاب میشود تا نام مولد نیز در گزارش وجود داشته باشد. این انتخاب، تضمین یکسان بودن همهٔ خروجیهای اعشاری در تمام رایانهها و نسخههای آینده نیست. برای بازسازی دقیقتر، ورودی نهایی آزمایش را نیز ذخیره کنید. در دادهٔ واقعی، فایلی که حسگر ثبت کرده جایگزین بذر نیست؛ بذر فقط به بخشهای تصادفی برنامه مربوط است.
برای تشخیص تغییر داده، یک اثر انگشت از محتوا میسازیم. تابع نمونه، شکل آرایه، نوع عددی و ترتیب حافظهٔ قراردادی را همراه بایتهای داده در هش وارد میکند. به این ترتیب، دو آرایه با اعداد یکسان ولی شکل متفاوت بیدلیل یکسان معرفی نمیشوند. hashlib در پایتون ابزار محاسبهٔ SHA-256 را فراهم میکند. هش جای فایل داده، توضیح واحد، مجوز استفاده یا بررسی علمی را نمیگیرد؛ کاربرد آن در اینجا تشخیص برابری محتوای قراردادی است.
۳. کد کامل برای اجرای دوبارهٔ آزمایش
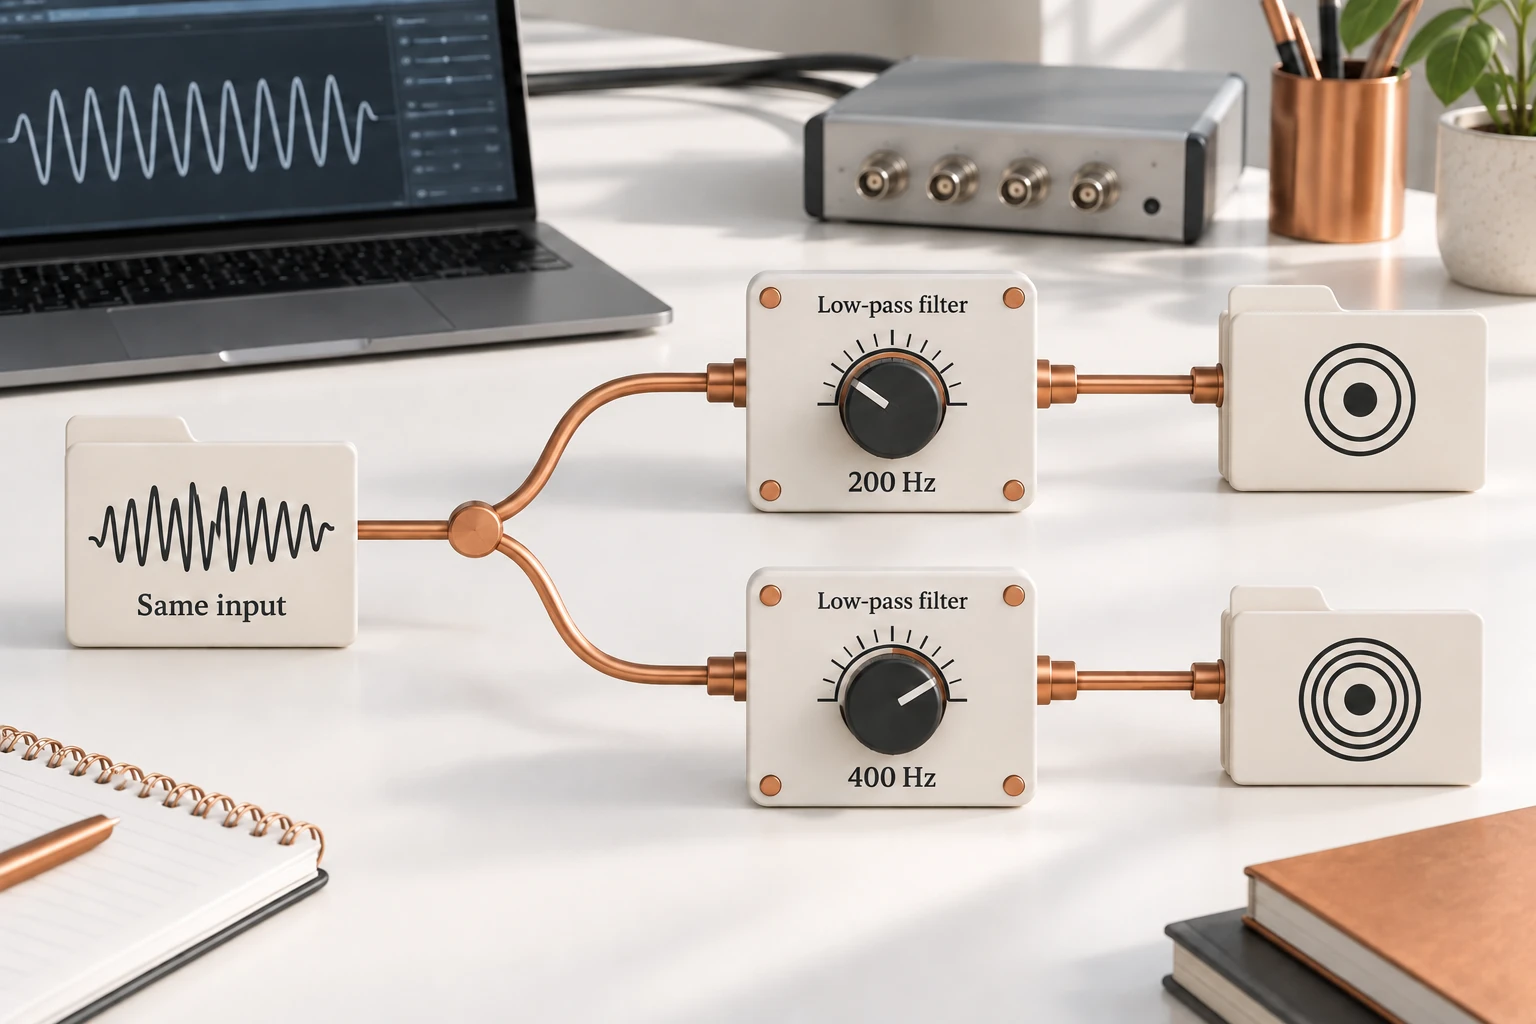
کد زیر ورودی مصنوعی را میسازد، فیلتر را اجرا میکند و گزارش شامل پیکربندی، هش ورودی و خروجی، نسخهٔ کتابخانهها و مقدار خطا را چاپ میکند. ابتدا یک آزمایش با فرکانس قطع ۲۰۰ هرتز انجام میشود. سپس همان ورودی و همان تنظیمات دوباره اجرا میشوند. در مرحلهٔ سوم، ورودی قبلی حفظ و فرکانس قطع به ۴۰۰ هرتز تغییر میکند. در پایان، یک عدد تصادفی اضافه پیش از ساخت داده مصرف میشود تا اثر تغییر ترتیب فراخوانی آشکار شود.
فیلتر با butter در SciPy و خروجی SOS ساخته میشود. آرگومان fs واحد فرکانس قطع را با نرخ نمونهبرداری هماهنگ میکند. اجرا با sosfiltfilt، یعنی فیلتر رفتوبرگشتی آفلاین، انجام میشود. این روش برای مثالِ آرایهٔ کامل انتخاب شده و نباید بدون تغییر بهعنوان فیلتر زندهٔ یک کنترلکننده معرفی شود.
فایل را با نام reproducible_signal.py ذخیره کنید و NumPy و SciPy را در محیط پروژه نصب کنید. بذر، نرخ، طول، مؤلفهها و معیار در خود فایل مشخصاند؛ ورودی خارجی، تماس با سرویس، حساب کاربری یا دادهٔ خصوصی لازم نیست. شرطهای assert، فرضیات موردنیاز این آزمایش را بررسی میکنند. یکسان بودن بایتها، تنها در اجرای آزمودهشدهٔ همین محیط گزارش میشود.
"""Authored synthetic engineering experiment, not measured machine data."""
import hashlib
import json
import platform
import numpy as np
import scipy
from scipy.signal import butter, sosfiltfilt


def array_hash(x):
    # The hash refers to shape + little-endian float64 C-order values.
    header = json.dumps({'shape':list(x.shape),'dtype':'<f8','order':'C'},sort_keys=True).encode()
    return hashlib.sha256(header+b'\n'+np.asarray(x,dtype='<f8').tobytes(order='C')).hexdigest()


def make_input(seed=20261014, skip_one_draw=False):
    generator=np.random.Generator(np.random.PCG64(seed))
    if skip_one_draw:
        generator.standard_normal(1)
    sample_rate=2000
    t=np.arange(4000)/sample_rate
    reference=np.sin(2*np.pi*100*t)
    x=reference+0.25*np.sin(2*np.pi*700*t)+0.1*generator.standard_normal(t.size)
    return reference,x


def run_on_data(reference,x,cutoff_hz=200):
    config={'sample_rate_hz':2000,'duration_s':2,'cutoff_hz':cutoff_hz,
            'order':4,'method':'sosfiltfilt','metric_trim_samples':100,'unit':'arbitrary synthetic amplitude'}
    sos=butter(config['order'],config['cutoff_hz'],fs=config['sample_rate_hz'],output='sos')
    output=sosfiltfilt(sos,x)
    trim=config['metric_trim_samples']
    error=output[trim:-trim]-reference[trim:-trim]
    return {'config':config,'config_sha256':hashlib.sha256(json.dumps(config,sort_keys=True).encode()).hexdigest(),
            'input_sha256':array_hash(x),'output_sha256':array_hash(output),
            'rmse':float(np.sqrt(np.mean(error**2)))},output


reference,x=make_input()
same_reference,same_x=make_input()
first,y=run_on_data(reference,x)
repeated,same_y=run_on_data(same_reference,same_x)
changed_cutoff,other_y=run_on_data(reference,x,400)
shifted_reference,shifted_x=make_input(skip_one_draw=True)
raw_rmse=float(np.sqrt(np.mean((x[100:-100]-reference[100:-100])**2)))
assert np.array_equal(x,same_x) and np.array_equal(y,same_y)
assert first==repeated
assert first['input_sha256']==changed_cutoff['input_sha256']
assert first['config_sha256']!=changed_cutoff['config_sha256']
assert first['output_sha256']!=changed_cutoff['output_sha256']
assert array_hash(x)!=array_hash(shifted_x)
assert first['rmse']<raw_rmse
assert y.shape==x.shape and np.isfinite(y).all()
print(json.dumps({'versions':{'python':platform.python_version(),'numpy':np.__version__,'scipy':scipy.__version__},
                  'seed':20261014,'bit_generator':'PCG64','synthetic_example_only':True,
                  'first_run':first,'repeated_run_matches':first==repeated,'changed_cutoff_run':changed_cutoff,
                  'same_seed_extra_draw_changes_input':array_hash(x)!=array_hash(shifted_x),'raw_rmse':raw_rmse,
                  'checks':{'same_input_same_environment_repeat_exactly':True,'same_input_for_parameter_comparison':True,
                            'configuration_change_detected':True,'output_change_detected':True,
                            'extra_rng_call_detected':True,'filter_improves_synthetic_rmse':True,'finite_output_shape_preserved':True}},indent=2))
۴. نتیجهٔ اجرا و پاسخ تمرینها
گزارش زیر حاصل اجرای همین مثال است. عددهای خطا به سیگنال مصنوعی و قرارداد معیار وابستهاند؛ آنها را نرخ موفقیت یک محصول یا دقت تشخیص عیب معرفی نمیکنیم. تغییر فرکانس قطع، در این آزمایش خروجی را تغییر میدهد؛ «متفاوت بودن» بهتنهایی به معنی «بهتر بودن» نیست.
{
  "versions": {
    "python": "3.14.5",
    "numpy": "2.5.4",
    "scipy": "1.18.1"
  },
  "seed": 20261014,
  "bit_generator": "PCG64",
  "synthetic_example_only": true,
  "first_run": {
    "config": {
      "sample_rate_hz": 2000,
      "duration_s": 2,
      "cutoff_hz": 200,
      "order": 4,
      "method": "sosfiltfilt",
      "metric_trim_samples": 100,
      "unit": "arbitrary synthetic amplitude"
    },
    "config_sha256": "3f3a3e675104520622d78f8f0d65169f86d10b39d4100c8423f4981fa809250d",
    "input_sha256": "3eabddc103bed5e5bd4d9f8f62fe569293149bb8f296e215aa2cb1fc09d7d8e1",
    "output_sha256": "5b6a6b11f1a0773494847b7ba9dae70a578c7abee6f194b275b6eb63487df971",
    "rmse": 0.04293790471669297
  },
  "repeated_run_matches": true,
  "changed_cutoff_run": {
    "config": {
      "sample_rate_hz": 2000,
      "duration_s": 2,
      "cutoff_hz": 400,
      "order": 4,
      "method": "sosfiltfilt",
      "metric_trim_samples": 100,
      "unit": "arbitrary synthetic amplitude"
    },
    "config_sha256": "c01e1edfc9d4772a451e4bb0806090df889dad8a99518c4a56aede2955024ea0",
    "input_sha256": "3eabddc103bed5e5bd4d9f8f62fe569293149bb8f296e215aa2cb1fc09d7d8e1",
    "output_sha256": "cbfb731130d3b1de5cd94ac28506157a256c12e0e24a32f97a990a2eaa2c2c68",
    "rmse": 0.06040688729569012
  },
  "same_seed_extra_draw_changes_input": true,
  "raw_rmse": 0.2036752475597411,
  "checks": {
    "same_input_same_environment_repeat_exactly": true,
    "same_input_for_parameter_comparison": true,
    "configuration_change_detected": true,
    "output_change_detected": true,
    "extra_rng_call_detected": true,
    "filter_improves_synthetic_rmse": true,
    "finite_output_shape_preserved": true
  }
}
تمرین اول: چرا دو اجرای اولیه باید هش ورودی و خروجی یکسان داشته باشند؟ پاسخ: همان داده، همان تنظیمات و همان محیط استفاده شدهاند. کد علاوه بر هش، برابری آرایهها و کل گزارش را بررسی میکند. اگر این آزمون شکست خورد، ابتدا ورودی و پیکربندی را مقایسه کنید؛ فقط تکرار اجرای برنامه علت اختلاف را روشن نمیکند.
تمرین دوم: در مقایسهٔ فرکانس قطع ۲۰۰ و ۴۰۰ هرتز، چه چیز باید ثابت بماند؟ پاسخ: همان آرایهٔ ورودی و همان مرجع مصنوعی. کد شرط میگذارد که هش ورودی ثابت و هش تنظیمات و خروجی متفاوت باشند. اگر برای هر فیلتر اغتشاش تازه بسازیم، اختلاف نتیجه میتواند ناشی از داده باشد و مقایسهٔ اثر پارامتر مخدوش شود.
تمرین سوم: آیا همان بذر با یک فراخوانی تصادفی اضافه، همان ورودی را میسازد؟ پاسخ: در مثال اجراشده خیر؛ شرط مربوط به تغییر هش ورودی پاس میشود. این مشاهده دلیل کافی برای ثبت ترتیب عملیات و ذخیرهٔ ورودی است. این نتیجه را به حکم عمومی دربارهٔ تمام مولدها و تمام توزیعها گسترش نمیدهیم.
تمرین چهارم: آیا پاس شدن همهٔ شرطها، کیفیت علمی روش را ثابت میکند؟ پاسخ: خیر. شرطها قرارداد اجرای همین مثال را بررسی میکنند. انتخاب دادهٔ نماینده، طراحی آزمون مستقل، بررسی حساسیت پارامترها و خطای اندازهگیری هنوز لازم است. اجرای کاملاً تکرارپذیر ممکن است فرض یا معیار نامناسبی داشته باشد.
۵. چه بستهای به مهندس بعدی تحویل دهیم؟
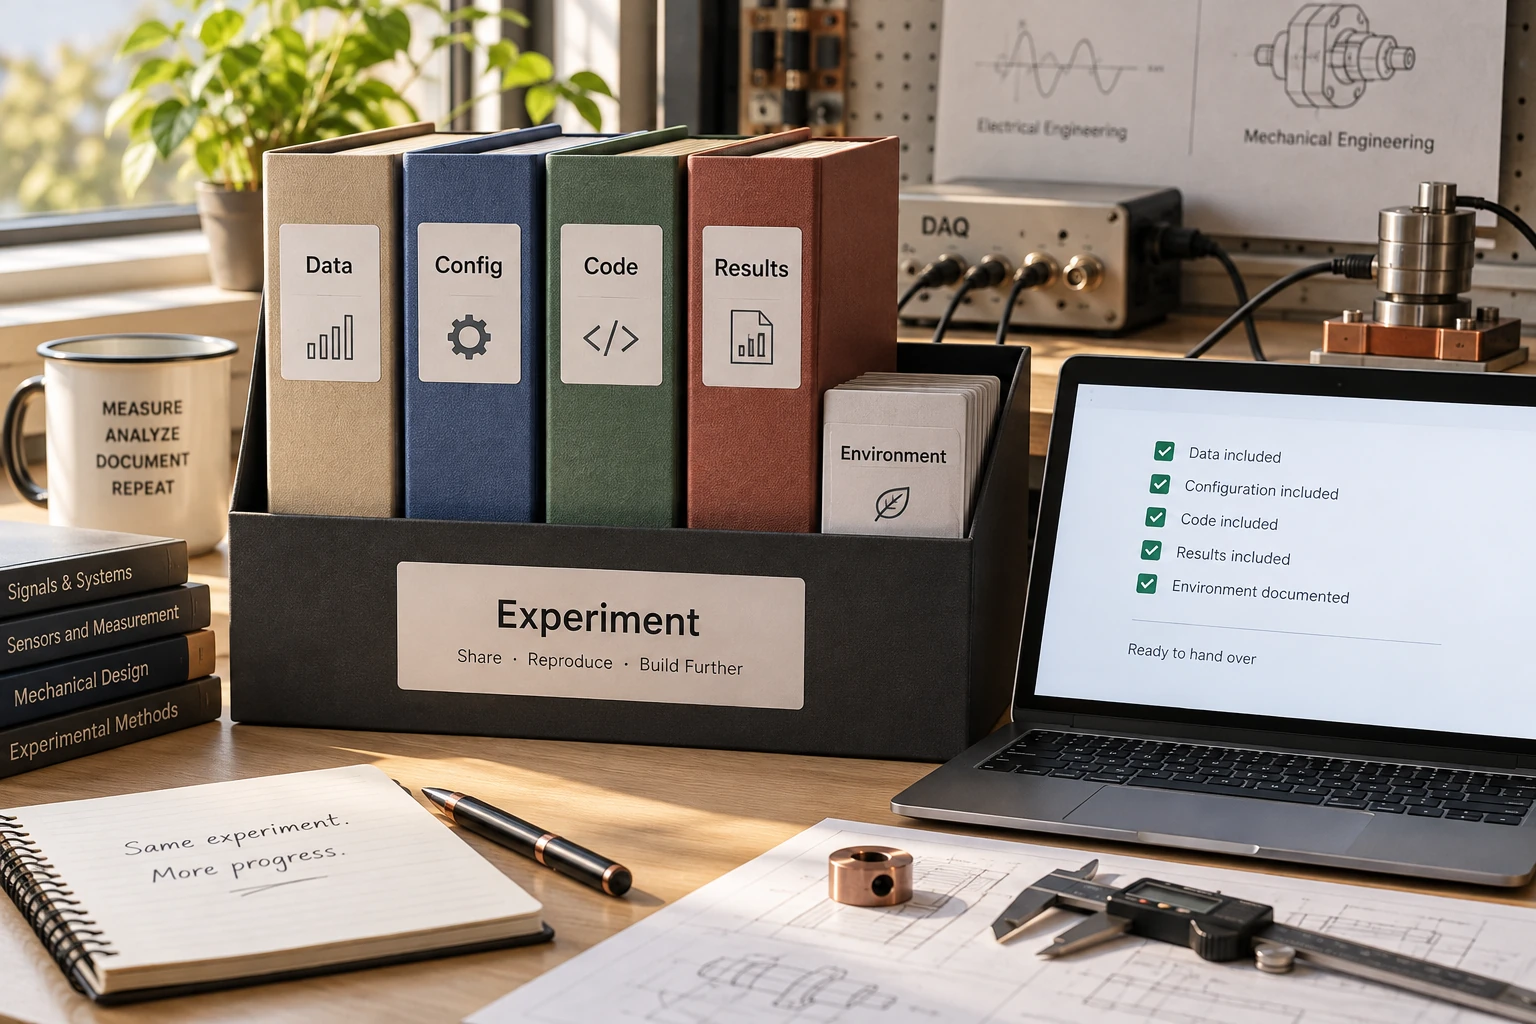
بستهٔ آزمایش باید دادهٔ ورودی یا روش دقیق تولید آن، پیکربندی، کد، نسخهٔ محیط و گزارش نتیجه را داشته باشد. فهرست فایلها و قرارداد هش را کنار آن نگه دارید. اگر داده با ابزار واقعی ثبت شده است، نرخ واقعی نمونهبرداری، واحد حسگر، تبدیل مقیاس و تنظیمات ثبت را نیز اضافه کنید. تصویر نمودار میتواند کمک کند، اما فایل داده و روش محاسبهٔ آن را جایگزین نمیکند.
اگر هدف شما آموزش مدل هوش مصنوعی است، شناسهٔ نمونههای آموزش و آزمون، روش تقسیم داده و نسخهٔ پیشپردازش را هم ثبت کنید. برای سیستمهایی که روی ماشینها یا کاربران متفاوت اجرا میشوند، گزارش روشن کند که کدام آزمون بازسازی محاسبات است و کدام آزمون ارزیابی روی شرایط تازه. یک نتیجهٔ موفق روی سیگنال دوثانیهای این مقاله، شواهد کافی برای کاربرد صنعتی نیست.
ثبت اطلاعات باید بهاندازهٔ نیاز انجام شود. دادهٔ خام شخصی، کلید دسترسی یا اطلاعات محرمانه را برای «کامل بودن گزارش» در خروجی عمومی نگذارید؛ مقالهٔ طراحی گزارش رویداد بدون تکثیر دادهٔ حساس اصل مرتبطی را توضیح میدهد. در یک گزارش مهندسی قابل بازبینی، خواننده باید بداند چه چیزی اجرا شده، چه چیزی هنوز اجرا نشده و کدام محدودیتها باقیاند. هدف، امکان بررسی و یادگیری از نتیجه است.
منابع و مطالعهٔ بیشتر
- سیاست سازگاری جریان تصادفی در NumPy
- مولد PCG64 در NumPy
- ساخت فیلتر Butterworth در SciPy
- فیلتر رفتوبرگشتی SOS در SciPy
- محاسبهٔ هش با hashlib در پایتون
بررسی منابع: ۲۲ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.