فهرست مقاله
در آزمونِ یک مسیرِ دادهٔ مهندسی، لازم نیست همیشه یک طبقهبندِ کامل اجرا کنیم تا خطای پیشپردازش را ببینیم. گاهی یک شاهدِ کوچک، مرزِ مسئولیتِ دو ماژول را روشنتر میکند: یکی آمارِ آموزش را میسازد و دیگری با همان حالت، دادهٔ بعدی را تبدیل میکند. این درس، همین مرز را با چهار مقدارِ ولتاژِ ساختگی میسنجد. مدلِ پیشبینی، برچسبِ خرابی، حسگرِ واقعی و امتیازِ کیفیتِ هوش مصنوعی در آن وجود ندارند.
۱. ولتاژِ ورودی و امتیازِ بیبُعدِ خروجی
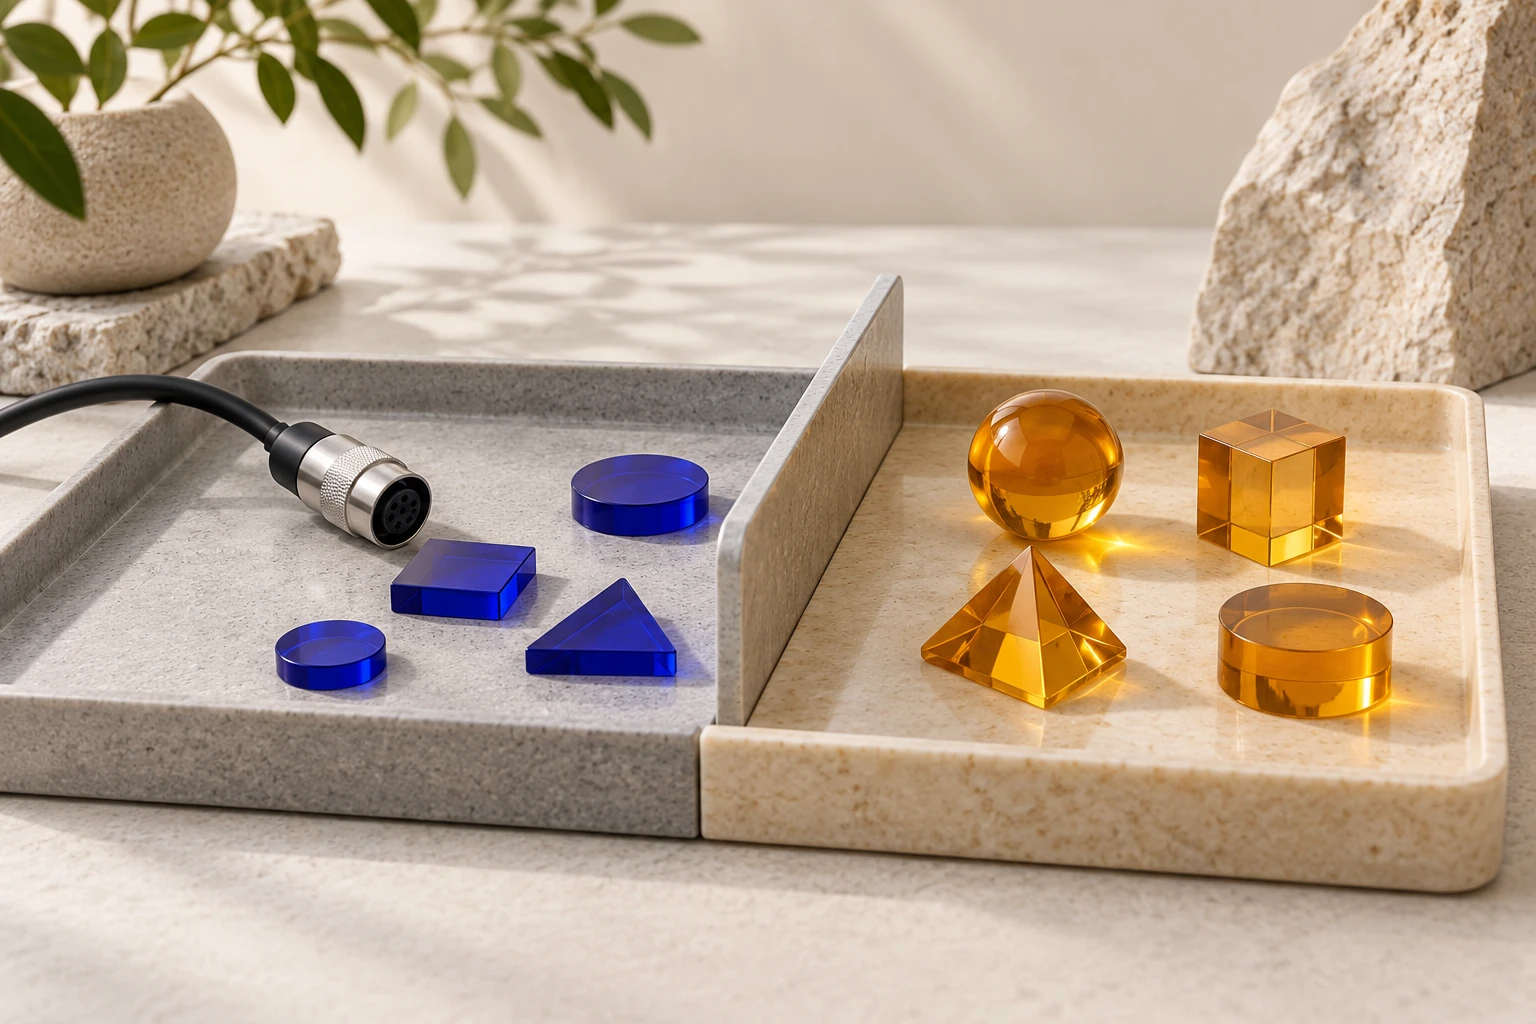
دادهٔ آموزش، یک و سه ولت و دادهٔ کنارگذاشتهشده، ۱۰۱ و ۱۰۳ ولت است. این فاصلهٔ بزرگ عمداً برای آشکارکردنِ تغییرِ تبدیل انتخاب شده؛ محدودهٔ کاریِ یک ابزار یا پیشنهادِ اتصالِ حسگر نیست. فقط یک ویژگی داریم. ترتیبِ ستونها، دادهٔ چندکاناله، وزنِ نمونه و اندازهگیریِ نویز در این قرارداد وارد نشدهاند؛ نامِ «حسگر» معنای واقعی به اعدادِ ساختگی نمیدهد.
امتیازِ استاندارد از تفاضلِ مقدار و میانگینِ آموزش، تقسیم بر انحرافِ معیارِ آموزش به دست میآید. میانگین و مقیاس، هر دو واحدِ ولت دارند؛ خروجی بیبُعد است. برای یک و سه، میانگین دو و واریانسِ توصیفی یک ولتِ مربع است؛ پس مقیاس یک ولت میشود. مخرجِ واریانس تعدادِ دو است، نه تعداد منهای یک؛ در اینجا برآوردِ واریانسِ نمونه را درخواست نکردهایم.
مرجعِ StandardScaler، فرمول و نگهداریِ آمارِ آموزش برای تبدیلِ بعدی را توضیح میدهد. نتیجهٔ آموزشِ همین مثال منفی یک و مثبت یک است، اما دادهٔ جدا ۹۹ و ۱۰۱ میشود. استانداردسازی، محدودسازی به بازهٔ منفی یک تا یک یا تضمینِ توزیعِ نرمال نیست. بزرگبودنِ عددِ تبدیلشده را بدونِ قراردادِ جدا، با بریدنِ خروجی پنهان نمیکنیم.
۲. حالتِ برازش را از عملِ تبدیل جدا کنیم
راهنمای خطاهای متداولِ scikit-learn تأکید میکند پیشپردازشِ آموختنی باید از آموزش برازش شود، سپس همان تبدیل بر آزمون اعمال شود. یکسانبودنِ عبارتِ ریاضی کافی نیست: اگر میانگین و مقیاس را برای هر مجموعه از نو بسازیم، عملاً تبدیلهای متفاوت داریم. ماژولِ تبدیلِ این درس اصلاً مسیرِ محاسبهٔ دوبارهٔ آمار را ندارد؛ حالتِ آماده را میگیرد.
حالت، چهار فیلدِ ساده دارد: میانگینِ ولتاژ، مقیاسِ ولتاژ، تعدادِ آموزش و واحد. آن را با dataclass دارایِ frozen=True میسازیم تا انتسابِ معمول به فیلدها خطا بدهد. مرجعِ dataclasses این رفتار را شبیهسازیِ تغییرناپذیری میداند؛ شیءِ کاملاً دستکاریناپذیر یا مرزِ امنیتی نیست. در این نمونه اعضا عدد و رشتهاند، نه اشیای قابلویرایشِ تودرتو.
نامِ fit_training نیز منبعِ داده را اثبات نمیکند؛ فراخواننده میتواند بهاشتباه دادهٔ آزمون را به آن بدهد. نمونهٔ عمدیِ اشتباه دقیقاً همین کار را میکند. ثابتبودنِ یک حالتِ ساختهشده، مدرکِ استقلالِ آموزش و آزمون، جداییِ دستگاهها یا ترتیبِ زمانیِ درست نیست. قراردادِ تقسیم و منشأِ داده باید در لایهٔ دیگری طراحی و بازبینی شود؛ این مثال گواهِ نبودِ همهٔ نشتهای اطلاعات نیست.
۳. کدِ کامل و قراردادِ محدودِ واحد و مقیاس
تابعِ برازش، tuple با دو تا ۶۴ مقدارِ int یا float دقیقِ متناهی میگیرد؛ قدرِ مقدار حداکثر هزار ولت است. دادهٔ تبدیل میتواند تهی باشد و همان سقفِ ۶۴ عضو را دارد. bool، رشته، NaN و بینهایت تبدیل نمیشوند. واحد باید دقیقاً V باشد؛ mV را باید پیش از ورود، با تصمیمِ روشن به ولت تبدیل کرد. این کرانها، دامنهٔ نرمافزاریِ تمریناند، نه مشخصاتِ الکتریکیِ دستگاه.
"""Separate bounded training fit from immutable-state sensor transforms."""
from dataclasses import asdict, dataclass, FrozenInstanceError
from fractions import Fraction
import json
import math
import platform


@dataclass(frozen=True)
class ScaleState:
    mean_v: float
    scale_v: float
    training_count: int
    unit: str = "V"


def values_in_volts(values, unit, minimum):
    if type(unit) is not str or unit != "V":
        raise ValueError("voltage_unit")
    if type(values) is not tuple or not minimum <= len(values) <= 64:
        raise ValueError("sample_count_shape")
    result = []
    for value in values:
        if type(value) not in (int, float) or (type(value) is float and not math.isfinite(value)):
            raise ValueError("voltage_type_finite")
        if not -1000 <= value <= 1000:
            raise ValueError("voltage_range")
        result.append(float(value))
    return tuple(result)


def fit_training(values, *, unit="V"):
    data = values_in_volts(values, unit, 2)
    mean = math.fsum(data) / len(data)
    variance = math.fsum((value - mean) ** 2 for value in data) / len(data)
    scale = math.sqrt(variance)
    if scale < 1e-6:
        raise ValueError("training_scale_too_small")
    return ScaleState(mean, scale, len(data), unit)


def transform(state, values, *, unit="V"):
    if type(state) is not ScaleState:
        raise ValueError("fitted_state_type")
    if (type(state.mean_v) is not float or not math.isfinite(state.mean_v) or not -1000 <= state.mean_v <= 1000
            or type(state.scale_v) is not float or not math.isfinite(state.scale_v) or not 1e-6 <= state.scale_v <= 2000
            or type(state.training_count) is not int or not 2 <= state.training_count <= 64
            or type(state.unit) is not str or state.unit != "V"):
        raise ValueError("fitted_state_contract")
    data = values_in_volts(values, unit, 0)
    return tuple((value - state.mean_v) / state.scale_v for value in data)


def exact_moments(values):
    # Independent raw second-moment Fraction formula, not centered floating squares.
    data = tuple(Fraction.from_float(float(value)) for value in values)
    mean = sum(data, Fraction(0)) / len(data)
    variance = sum((value * value for value in data), Fraction(0)) / len(data) - mean * mean
    return mean, variance


def error(call):
    try:
        call()
    except ValueError as exc:
        return str(exc)
    return None


def run_example():
    checks = {}
    def check(name, value):
        checks[name] = bool(value)
        if not checks[name]:
            raise AssertionError(name)
    close = lambda a, b: math.isclose(a, b, rel_tol=2e-12, abs_tol=2e-12)
    training, held_out = (1.0, 3.0), (101.0, 103.0)
    state = fit_training(training)
    original = asdict(state)
    train_z = transform(state, training)
    test_z = transform(state, held_out)
    check("hand_training_mean2_scale1_count2", state == ScaleState(2.0, 1.0, 2, "V"))
    check("training_values_map_to_minus1_plus1", train_z == (-1.0, 1.0))
    check("heldout_values_use_training_state_99_101", test_z == (99.0, 101.0))
    check("transform_does_not_refit_or_mutate_state", asdict(state) == original and state.training_count == 2)
    changed_test = transform(state, (-101.0, -103.0))
    check("different_test_data_cannot_change_existing_fit_state", changed_test == (-103.0, -105.0) and asdict(state) == original)
    bad_refit = fit_training(held_out)  # Deliberately wrong caller flow, not a recommended operation.
    check("deliberately_wrong_refit_on_test_has_different_state_and_output", bad_refit.mean_v == 102.0
          and transform(bad_refit, held_out) == (-1.0, 1.0) and transform(bad_refit, held_out) != test_z)
    bad_combined = fit_training(training + held_out)
    check("deliberately_wrong_combined_fit_mean52_variance2501", bad_combined.mean_v == 52.0
          and close(bad_combined.scale_v, math.sqrt(2501.0))
          and all(close(x, y) for x, y in zip(transform(bad_combined, held_out), (49 / math.sqrt(2501), 51 / math.sqrt(2501)))))
    check("standard_scores_are_not_clipped_to_unit_interval", min(test_z) > 1.0)
    check("training_order_does_not_change_small_fixture_state", fit_training(training[::-1]) == state)
    doubled = fit_training(tuple(2 * value for value in training))
    check("common_positive_gain_preserves_dimensionless_transforms", transform(doubled, tuple(2 * value for value in held_out)) == test_z)
    shifted = fit_training(tuple(value + 10 for value in training))
    check("common_offset_preserves_transform_when_fit_is_consistent", transform(shifted, tuple(value + 10 for value in held_out)) == test_z)
    frozen = False
    try:
        state.mean_v = 102.0
    except FrozenInstanceError:
        frozen = True
    check("usual_field_assignment_is_rejected_not_a_security_boundary", frozen and asdict(state) == original)
    cases = 0
    for rows in ((0, 2), (-4, 0, 4), (1, 2, 5), (-3, -1, 2, 6)):
        fitted = fit_training(rows)
        mean, variance = exact_moments(rows)
        expected_scale = math.sqrt(float(variance))
        if not close(fitted.mean_v, float(mean)) or not close(fitted.scale_v, expected_scale):
            raise AssertionError("independent_exact_moments")
        for test in (-7, 0, 9):
            expected = float(Fraction(test) - mean) / expected_scale
            if not close(transform(fitted, (test,))[0], expected):
                raise AssertionError("independent_transform_reference")
            cases += 1
    check("12_fraction_moment_transform_cases_one_group", cases == 12)
    check("empty_test_transform_is_empty_and_state_unchanged", transform(state, ()) == () and asdict(state) == original)
    check("bounded_units_types_counts_and_minimum_scale", error(lambda: fit_training((1,))) == "sample_count_shape"
          and error(lambda: fit_training((1.0,) * 65)) == "sample_count_shape"
          and error(lambda: fit_training((1, 1))) == "training_scale_too_small"
          and error(lambda: fit_training((0, 1e-8))) == "training_scale_too_small"
          and error(lambda: fit_training((1, 3), unit="mV")) == "voltage_unit"
          and all(error(lambda v=v: transform(state, (v,))) == "voltage_type_finite" for v in (True, "1", float("nan"), float("inf")))
          and error(lambda: transform(state, (10 ** 400,))) == "voltage_range"
          and error(lambda: transform(state, [1])) == "sample_count_shape")
    check("transform_requires_valid_fitted_state", error(lambda: transform(None, (1,))) == "fitted_state_type"
          and error(lambda: transform(ScaleState(2.0, 0.0, 2), (1,))) == "fitted_state_contract"
          and error(lambda: transform(ScaleState(2.0, 1.0, True), (1,))) == "fitted_state_contract")
    return {"python_version": platform.python_version(), "executed_library": "own stdlib-only teaching implementation, not sklearn StandardScaler",
            "contract": "single synthetic voltage feature; exacttuple up to64, finiteint/float in[-1000,1000]V, trainmin2, populationstd>=1e-6V, immutable primitive fields, transformed z dimensionless; no missing data",
            "training_state": original, "training_z": list(train_z), "heldout_z_using_training": list(test_z),
            "deliberately_wrong_test_refit_state": asdict(bad_refit),
            "deliberately_wrong_combined_state": asdict(bad_combined),
            "deliberately_wrong_combined_heldout_z": list(transform(bad_combined, held_out)),
            "independent_reference_cases_one_group": cases,
            "comparison_tolerance": {"relative": 2e-12, "absolute_in_compared_quantity_unit": 2e-12, "quantities": "mean/scale V; z dimensionless"},
            "limitations": "Caller chooses what is training data: API names/frozen fields do not certify independence, group/time split or all leakage prevention. Frozen dataclass resists usual assignment, not hostile bypass/deep immutability. No classifier, model score, sklearn execution, benchmark or device data. Own constant/tiny-scale/NaN rejection differs from StandardScaler policies; not full library parity.",
            "checks": checks}


if __name__ == "__main__":
    print(json.dumps(run_example(), ensure_ascii=False, indent=2))
مقیاسِ آموزش باید دستکم ده به توان منفی شش ولت باشد؛ دادهٔ ثابت یا مقیاسِ کوچکتر رد میشود. این سیاستِ انتخابیِ ماست. StandardScaler برای واریانسِ صفر ضریبِ یک میگذارد و دربارهٔ NaN هم رفتارِ مستندِ دیگری دارد؛ مثالِ حاضر جایگزینِ کاملِ آن API نیست. کتابخانهٔ scikit-learn در محیطِ فعال نصب نیست و این کد اجرای آن را ادعا نمیکند؛ هیچ بستهای نیز نصب نشده است.
transform شکل و دامنهٔ حالتِ برازش را کنترل میکند، سپس فقط تفاضل و تقسیم انجام میدهد. حالت را بازنویسی و تعدادِ آموزش را زیاد نمیکند. اگر کسی یک ScaleState با فیلدِ ظاهراً معتبر اما منشأِ غلط بسازد، این کنترل منشأ را کشف نمیکند. بنابراین اعتبارِ ساختاریِ شیء را با اعتبارِ روشِ پژوهش یکی نمیگیریم؛ آزمونِ مرزِ ماژول فقط بخشی از شواهد است.
۴. مرجعِ مستقل و دو بازبرازشِ عمداً نادرست
اگر فقط دادهٔ آزمونِ ۱۰۱ و ۱۰۳ را برازش کنیم، میانگین ۱۰۲ و مقیاس یک میشود؛ همان داده به منفی یک و مثبت یک میرود. این نتیجه از نظرِ حسابِ محلی درست است، اما تبدیلِ آموختهشده از آموزش نیست. خروجیِ درست با حالتِ اصلی، همچنان ۹۹ و ۱۰۱ است. آزمون باید حالت و جوابِ دستی را بسنجد، نه صرفاً مرتب یا کوچکبودنِ عددهای خروجی را.
{
  "python_version": "3.14.5",
  "executed_library": "own stdlib-only teaching implementation, not sklearn StandardScaler",
  "contract": "single synthetic voltage feature; exacttuple up to64, finiteint/float in[-1000,1000]V, trainmin2, populationstd>=1e-6V, immutable primitive fields, transformed z dimensionless; no missing data",
  "training_state": {
    "mean_v": 2.0,
    "scale_v": 1.0,
    "training_count": 2,
    "unit": "V"
  },
  "training_z": [
    -1.0,
    1.0
  ],
  "heldout_z_using_training": [
    99.0,
    101.0
  ],
  "deliberately_wrong_test_refit_state": {
    "mean_v": 102.0,
    "scale_v": 1.0,
    "training_count": 2,
    "unit": "V"
  },
  "deliberately_wrong_combined_state": {
    "mean_v": 52.0,
    "scale_v": 50.00999900019995,
    "training_count": 4,
    "unit": "V"
  },
  "deliberately_wrong_combined_heldout_z": [
    0.9798040587804069,
    1.019796061179607
  ],
  "independent_reference_cases_one_group": 12,
  "comparison_tolerance": {
    "relative": 2e-12,
    "absolute_in_compared_quantity_unit": 2e-12,
    "quantities": "mean/scale V; z dimensionless"
  },
  "limitations": "Caller chooses what is training data: API names/frozen fields do not certify independence, group/time split or all leakage prevention. Frozen dataclass resists usual assignment, not hostile bypass/deep immutability. No classifier, model score, sklearn execution, benchmark or device data. Own constant/tiny-scale/NaN rejection differs from StandardScaler policies; not full library parity.",
  "checks": {
    "hand_training_mean2_scale1_count2": true,
    "training_values_map_to_minus1_plus1": true,
    "heldout_values_use_training_state_99_101": true,
    "transform_does_not_refit_or_mutate_state": true,
    "different_test_data_cannot_change_existing_fit_state": true,
    "deliberately_wrong_refit_on_test_has_different_state_and_output": true,
    "deliberately_wrong_combined_fit_mean52_variance2501": true,
    "standard_scores_are_not_clipped_to_unit_interval": true,
    "training_order_does_not_change_small_fixture_state": true,
    "common_positive_gain_preserves_dimensionless_transforms": true,
    "common_offset_preserves_transform_when_fit_is_consistent": true,
    "usual_field_assignment_is_rejected_not_a_security_boundary": true,
    "12_fraction_moment_transform_cases_one_group": true,
    "empty_test_transform_is_empty_and_state_unchanged": true,
    "bounded_units_types_counts_and_minimum_scale": true,
    "transform_requires_valid_fitted_state": true
  }
}
اگر هر چهار مقدار را پیش از جداسازی برازش کنیم، میانگین ۵۲ و واریانس ۲۵۰۱ ولتِ مربع میشود؛ مقیاس تقریباً ۵۰٫۰۱ ولت است. خروجیِ آزمون حدود ۰٫۹۷۹۸ و ۱٫۰۱۹۸ خواهد شد. این شاهد نشان میدهد اطلاعاتِ بخشِ جدا واردِ حالت شده است؛ هیچ طبقهبندی اجرا نشده که از آن بهبود یا کاهشِ دقت نتیجه بگیریم. جهت و اندازهٔ اثر بر معیارِ یک مدل، مسئلهٔ دیگری است.
مرجعِ مستقل با Fraction، گشتاورِ دومِ دقیق منهای مربعِ میانگین را میگیرد؛ تابعِ اصلی مربعِ فاصلهها از میانگین را جمع میکند. دوازده ترکیبِ کوچکِ آموزش و مقدارِ آزمون، یک گروه از شانزده گروهِ بررسیاند. برای مقایسه، تلورانسِ نسبی و مطلق دو ضربدر ده به توان منفی دوازده است؛ مطلق در واحدِ همان کمیت، یعنی ولت برای میانگین و مقیاس و بیبُعد برای خروجی، تفسیر میشود.
در آزمایش، عوضکردنِ دادهٔ آزمون با منفیِ همان مقدارها، حالتِ آموزش را تغییر نمیدهد؛ جوابِ تازه منفی ۱۰۳ و منفی ۱۰۵ است. ترتیبِ آموزشِ کوچک، جابهجاییِ مشترکِ آفست و تغییرِ بهرهٔ مثبتِ هر دو مجموعه نیز با قراردادِ سازگار سنجیده شدهاند. موفقیتِ این شاهدها، دقتِ کاملِ همهٔ دادههای نزدیکِ ثابت یا همهٔ انواعِ نمایشِ عددی را تضمین نمیکند؛ دامنهٔ محدود همچنان مهم است.
اعتبارسنجیِ dataclass حسگر نوع و دامنهٔ رکورد را جدا توضیح میدهد؛ معیارهای دستهبندیِ عیب هم مرحلهٔ ارزیابیِ پاسخهاست. اینجا هیچ معیارِ پیشبینی گزارش نشده است. کدِ تألیفی فقط با Python 3.14.5 و کتابخانهٔ استاندارد اجرا شده؛ مستنداتِ مرجع scikit-learn 1.9.1 و Python 3.14.8 در ۲۵ مهر ۱۴۰۵ خوانده شدهاند.
۵. چهار پرسش با پاسخِ کامل
پرسش اول: با آموزشِ یک و سه ولت، ۱۰۱ ولت به چه تبدیل میشود؟ پاسخ: میانگین دو و مقیاس یک است؛ نتیجه ۹۹، بیبُعد. خروجی را نباید صرفاً بهدلیلِ بزرگبودن با یک جایگزین کرد.
پرسش دوم: چرا برازشِ جداگانهٔ آزمون، منفی یک و مثبت یک میدهد؟ پاسخ: آمارِ تازه از خودِ ۱۰۱ و ۱۰۳ ساخته شده است. فرمول یکسان، حالتِ متفاوت دارد و دیگر تبدیلِ آموختهشده از دادهٔ آموزش نیست.
پرسش سوم: برازشِ همهٔ چهار مقدار چه شاهدی دارد؟ پاسخ: میانگینِ ۵۲ و واریانسِ ۲۵۰۱، حضورِ دادهٔ جدا را در پارامترها نشان میدهند. کوچکترشدنِ خروجیِ آزمون، بهتنهایی امتیاز یا کیفیتِ یک مدلِ اجرانشده را ثابت نمیکند.
پرسش چهارم: frozen بودن، نبودِ نشتِ داده را ثابت میکند؟ پاسخ: خیر؛ فقط انتسابِ معمول به همین فیلدها را محدود میکند. دادهٔ غلط میتواند از ابتدا حالتِ ثابتی بسازد؛ منشأ، گروهبندی، ترتیبِ زمان و مرزهای دیگر باید جدا بررسی شوند.
منابع و مطالعهٔ بیشتر
- scikit-learn؛ پیشپردازش یکسان و نشت داده
- StandardScaler؛ آمار آموزش، فرمول، مخرج و سیاست دادهٔ ثابت
- Python dataclasses؛ معنای محدود frozen
- Python Fraction؛ مرجع دقیقِ ورودیِ نمایشیافته
بررسی منابع: ۲۵ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.