فهرست مقاله
در بازبینیِ کدِ دادهٔ حسگر، یک فهرست از «گروهها» ممکن است ظاهراً درست ساخته شود، اما هنگامِ مصرف دیگر رکوردی نداشته باشد. علت میتواند اشتراکِ تکرارگرِ ورودی باشد، نه حذفِ داده در شبکه. این درس رفتارِ واقعیِ itertools.groupby را با شش رویدادِ ساختگی بررسی میکند؛ گروهِ پیاپی، نسخهٔ مستقلِ ذخیرهشده و مرتبسازی را جدا میسنجیم. هیچ حسگر، سرور، مدلِ یادگیری یا اندازهگیریِ سرعت و حافظه در آزمایش وجود ندارد.
۱. گروهِ پیاپی با گروهِ سراسری فرق دارد
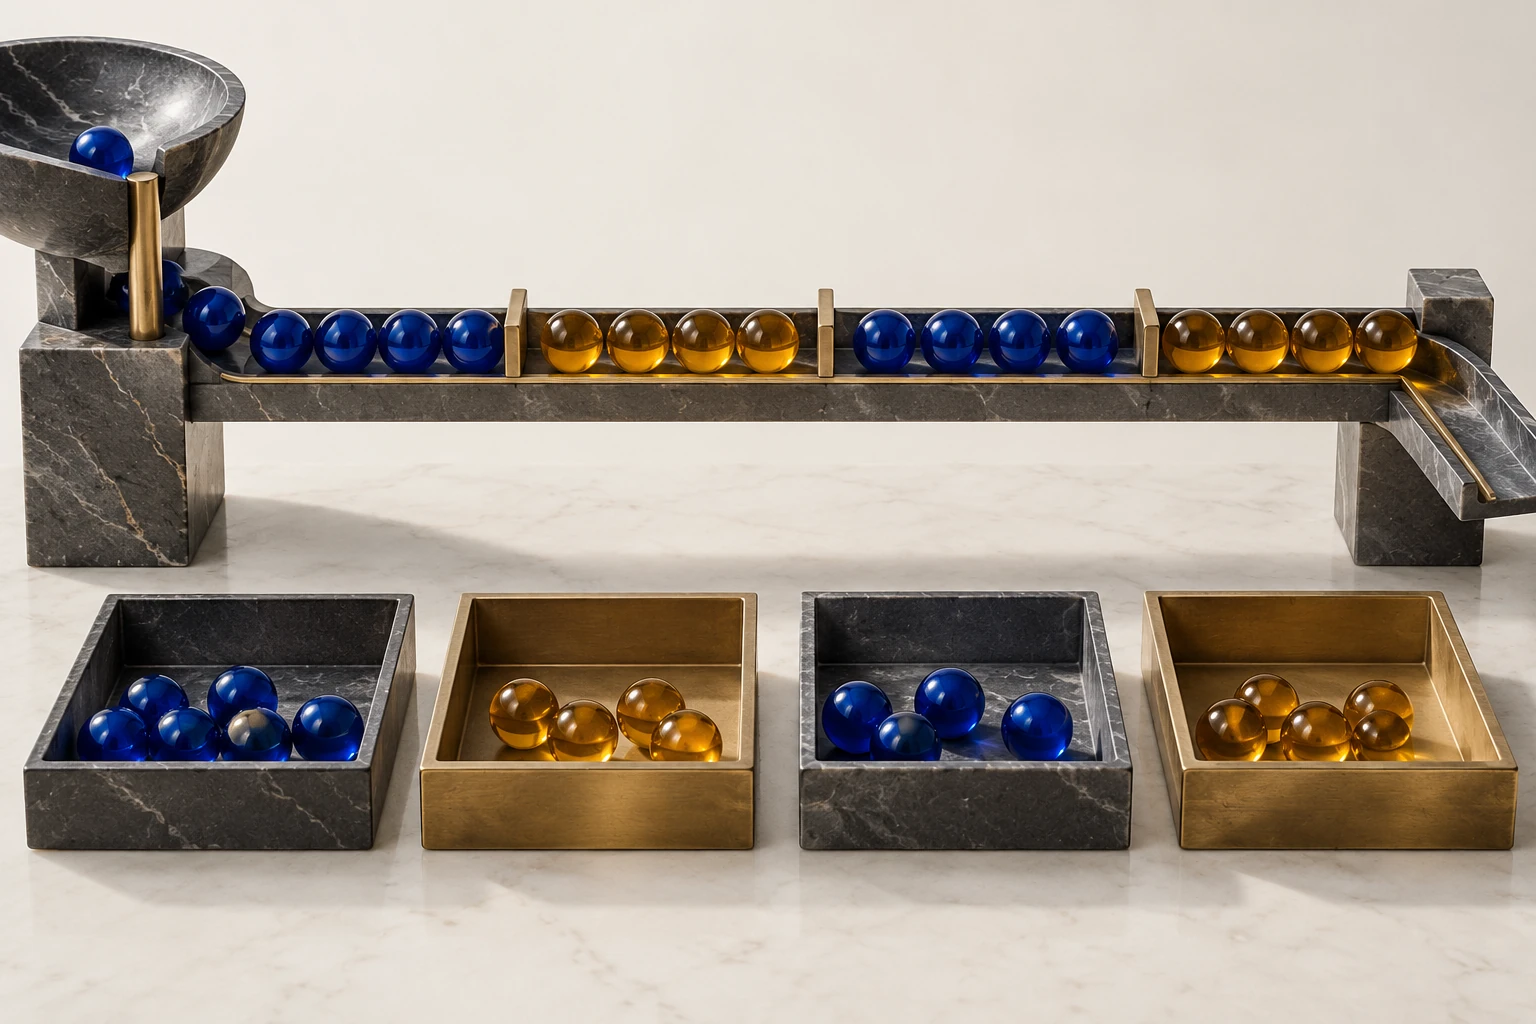
هر رکورد، سه عضو دارد: زمانِ صحیح بر حسبِ میلیثانیه، شناسهٔ حسگر و مقدارِ صحیح بر حسبِ میلیولت. ترتیبِ شش حسگر A،A،B،A،A،B است؛ زمانها از صفر تا پنج میروند. مقادیر بهترتیب ۱۰۰۰،۱۰۱۰،۲۰۰۰،۹۹۰،۹۸۰،۱۹۹۰ هستند. تمامِ اینها دادهٔ ثابتِ آزمایشاند؛ از فاصلهٔ یکمیلیثانیهای، نرخِ دریافتِ واقعی یا زمانبندیِ دستگاه نتیجه نمیگیریم.
مستنداتِ groupby میگوید گروهها از کلیدهای برابرِ پیاپی ساخته میشوند. تغییرِ کلید، گروهِ تازه میسازد؛ پس در این ورودی چهار گروه با طولهای دو، یک، دو و یک داریم. گروهِ دومِ A به اولی ملحق نمیشود. این رفتار با تجمیعِ سراسریِ رکوردهای دارایِ شناسهٔ برابر فرق دارد؛ نامِ آشنای تابع نباید آن دو پرسش را یکی کند.
این تفاوت برای مهندس معنی دارد: «یک اجرای پیاپی از حسگر» و «تمامِ دادههای آن حسگر در فایل» واحدِ گروهبندیِ یکسانی نیستند. کلید را آگاهانه روی شناسه میگذاریم و خودِ مقدارِ ولتاژ در شکستنِ گروه اثر ندارد. زمان نیز کلید نیست؛ فقط ترتیبِ مجازِ ورودی را کنترل میکند. اگر پرسشِ مسئله عوض شود، کلید و مرجعِ انتظار باید با هم بازتعریف شوند.
۲. گروه، تکرارگرِ مستقلِ کپیشده نیست
هشدارِ همان مرجع این است که گروهِ برگشتی، ورودی را با تکرارگرِ بیرونی شریک است. در آزمون، از گروهِ نخستِ A تنها رکوردِ زمانِ صفر را میخوانیم؛ سپس تکرارگرِ بیرونی را تا گروهِ B جلو میبریم. رکوردِ زمانِ یک برای عبور از گروهِ قبلی مصرف میشود. وقتی دوباره سراغِ گروهِ قدیمی میرویم، دیگر رکوردِ باقیماندهٔ آن را نمیگیریم؛ خروجیِ آن تهی است.
رکوردِ مرزیِ B گم نشده است؛ در گروهِ جدید باقی میماند. این تمایز، در بازبینیِ حلقه مهم است: دادهٔ باقیماندهٔ گروهِ رهاشده با نخستین دادهٔ گروهِ بعد یکسان نیست. مسیرِ ثبتِ مصرف در این اجرای کوچک، جایگاههای صفر، یک و دو را نشان میدهد. آن مشاهده را به شمارِ دقیقِ بافرخوانی یا زمانِ فراخوانیِ کلید در همهٔ پیادهسازیها تعمیم نمیدهیم.
تبدیلِ تکرارگرِ بیرونی به list هم کپیِ گروهها نمیسازد. در شاهدِ ما، چهار کلید درست در فهرست هستند، اما گروههای خام پس از پایانِ پیمایش تهیاند. ذخیرهکردنِ نشانیِ یک تکرارگر، ذخیرهکردنِ اعضای آن نیست. از روی چاپِ کلیدهای درست، نباید نتیجه گرفت رکوردها برای پردازشِ مرحلهٔ بعد حفظ شدهاند؛ خودِ اعضا را باید در آزمون مشاهده کرد.
۳. مصرفِ گروه پیش از پیشروی و کدِ کامل
راهِ انتخابیِ ما، ساختنِ tuple از اعضای هر گروه، پیش از درخواستِ گروهِ بعد است. دادهٔ این نمایه، فقط tupleهایی از رشته و عددِ صحیح دارد؛ اعضا تغییرپذیر نیستند. نسخهٔ ذخیرهشده پس از پیشروی باقی میماند. این توضیح، ادعای کپیِ عمیقِ هر نوع شیء نیست؛ اگر رکوردِ واقعی شاملِ فهرستِ قابلویرایش باشد، صرفِ ساختنِ tuple آن فهرست را مستقل نمیکند.
"""Actual itertools.groupby lifetime on bounded synthetic sensor records."""
import itertools
import json
import platform

RECORDS = ((0, "A", 1000), (1, "A", 1010), (2, "B", 2000),
           (3, "A", 990), (4, "A", 980), (5, "B", 1990))


def checked_records(iterable):
    """Own max64 records; timestamp ms nondecreasing; integer mV, no I/O."""
    previous = -1
    for count, row in enumerate(iterable, 1):
        if count > 64:
            raise ValueError("record_limit")
        if type(row) is not tuple or len(row) != 3:
            raise ValueError("record_shape")
        time_ms, sensor, voltage_mv = row
        if type(time_ms) is not int or not 0 <= time_ms <= 1_000_000:
            raise ValueError("timestamp_ms")
        if time_ms < previous:
            raise ValueError("chronology")
        if type(sensor) is not str or sensor not in ("A", "B"):
            raise ValueError("sensor_key")
        if type(voltage_mv) is not int or not -10000 <= voltage_mv <= 10000:
            raise ValueError("voltage_mv")
        previous = time_ms
        yield row


def snapshot_runs(iterable):
    # Consume each real group before advancing its shared outer iterator.
    return tuple((key, tuple(group)) for key, group in
                 itertools.groupby(checked_records(iterable), key=lambda row: row[1]))


def error(call):
    try:
        call()
    except ValueError as exc:
        return str(exc)
    return None


def independent_boundary_reference(rows):
    # Select all run starts from adjacent indices; does not use groupby or snapshot_runs.
    if not rows:
        return ()
    starts = [0] + [i for i in range(1, len(rows)) if rows[i][1] != rows[i - 1][1]]
    ends = starts[1:] + [len(rows)]
    return tuple((rows[start][1], rows[start:end]) for start, end in zip(starts, ends))


def run_example():
    checks = {}
    def check(name, value):
        checks[name] = bool(value)
        if not checks[name]:
            raise AssertionError(name)
    expected = (("A", ((0, "A", 1000), (1, "A", 1010))),
                ("B", ((2, "B", 2000),)),
                ("A", ((3, "A", 990), (4, "A", 980))),
                ("B", ((5, "B", 1990),)))
    runs = snapshot_runs(RECORDS)
    check("four_consecutive_runs_match_independent_literal_rows", runs == expected)
    check("nonadjacent_same_sensor_does_not_become_one_run", tuple(k for k, _ in runs) == ("A", "B", "A", "B"))
    check("run_sizes_and_integer_mv_sums_are_hand_values", tuple((len(g), sum(r[2] for r in g)) for _, g in runs) == ((2, 2010), (1, 2000), (2, 1970), (1, 1990)))
    pulled = []
    def source():
        for i, row in enumerate(RECORDS):
            pulled.append(i)
            yield row
    outer = itertools.groupby(source(), key=lambda row: row[1])
    check("constructing_groupby_does_not_pull_this_generator", pulled == [])
    first_key, first_group = next(outer)
    first_item = next(first_group)
    second_key, second_group = next(outer)
    check("outer_advance_discards_unconsumed_old_group", first_key == "A" and first_item == RECORDS[0]
          and second_key == "B" and tuple(first_group) == () and pulled == [0, 1, 2])
    check("next_group_retains_its_first_boundary_record", tuple(second_group) == (RECORDS[2],))
    pairs = list(itertools.groupby(RECORDS, key=lambda row: row[1]))
    check("storing_raw_group_iterators_does_not_snapshot_them", tuple(k for k, _ in pairs) == ("A", "B", "A", "B")
          and all(tuple(g) == () for _, g in pairs))
    outer2 = itertools.groupby(RECORDS, key=lambda row: row[1])
    key0, group0 = next(outer2)
    saved = tuple(group0)
    tuple(outer2)
    check("materialized_immutable_group_survives_outer_advance", key0 == "A" and saved == expected[0][1])
    traced = []
    def one_pass_source():
        for i, row in enumerate(RECORDS):
            traced.append(i)
            yield row
    generator = one_pass_source()
    captured = snapshot_runs(generator)
    check("bounded_known_source_read_once_and_then_exhausted", captured == expected and traced == list(range(6))
          and snapshot_runs(generator) == () and traced == list(range(6)))
    sorted_rows = tuple(sorted(RECORDS, key=lambda row: row[1]))
    global_groups = tuple((k, tuple(g)) for k, g in itertools.groupby(sorted_rows, key=lambda row: row[1]))
    check("stable_sensor_sort_merges_keys_but_changes_chronology", global_groups == (
        ("A", (RECORDS[0], RECORDS[1], RECORDS[3], RECORDS[4])),
        ("B", (RECORDS[2], RECORDS[5])))
        and tuple(row[0] for row in sorted_rows) == (0, 1, 3, 4, 2, 5)
        and error(lambda: snapshot_runs(sorted_rows)) == "chronology")
    bad_dictionary = dict(runs)
    check("dict_of_runs_overwrites_earlier_repeated_key", bad_dictionary == {"A": expected[2][1], "B": expected[3][1]}
          and sum(map(len, bad_dictionary.values())) == 3)
    check("empty_singleton_all_same_and_equal_timestamp_order", snapshot_runs(()) == ()
          and snapshot_runs(((0, "A", -50),)) == (("A", ((0, "A", -50),)),)
          and snapshot_runs(((0, "A", 1), (0, "A", 2))) == (("A", ((0, "A", 1), (0, "A", 2))),))
    cases = 0
    for n in range(6):
        for keys in itertools.product(("A", "B"), repeat=n):
            rows = tuple((i, key, i - 2) for i, key in enumerate(keys))
            actual = snapshot_runs(rows)
            if actual != independent_boundary_reference(rows) or tuple(r for _, group in actual for r in group) != rows:
                raise AssertionError("independent_boundary_reference")
            cases += 1
    check("63_adjacent_boundary_reference_sequences_one_group", cases == 63)
    invalids = (((True, "A", 0), "timestamp_ms"), ((float("nan"), "A", 0), "timestamp_ms"),
                ((0, "A", float("inf")), "voltage_mv"), ((0, "A", True), "voltage_mv"),
                ((0, "C", 0), "sensor_key"), ((0, "A", 10001), "voltage_mv"),
                ([0, "A", 0], "record_shape"), ((0, "A"), "record_shape"))
    check("types_ranges_and_three_field_unit_profile_rejected", all(error(lambda row=row: snapshot_runs((row,))) == code for row, code in invalids))
    check("64_record_cap_and_65th_rejection", len(snapshot_runs((i, "A", i) for i in range(64))[0][1]) == 64
          and error(lambda: snapshot_runs((i, "A", i) for i in range(65))) == "record_limit")
    consumed = []
    def invalid_later():
        for row in ((0, "A", 1), (1, "B", 2), (0, "B", 3)):
            consumed.append(row)
            yield row
    check("late_validation_error_does_not_undo_source_consumption", error(lambda: snapshot_runs(invalid_later())) == "chronology" and len(consumed) == 3)
    return {"python_version": platform.python_version(), "profile": "synthetic records(timestamp_ms, sensorAorB, voltage_mV), max64, integer bounded quantities, nondecreasing time, input order preserved; no I/O or sorting in snapshot_runs",
            "consecutive_run_keys": [key for key, _ in runs], "consecutive_run_sizes": [len(g) for _, g in runs],
            "run_sums_mv": [sum(r[2] for r in g) for _, g in runs],
            "sorted_sensor_timestamp_order_ms": [row[0] for row in sorted_rows],
            "old_group_after_outer_advance": [], "dictionary_retained_records": sum(map(len, bad_dictionary.values())),
            "independent_reference_sequences_one_group": cases,
            "limitations": "Materialized groups retain this bounded fixture; no constant-memory/speed claim. Shared group iterators are not independent snapshots; sorting by sensor changes global time order. A late validation failure does not rewind source effects; no transaction, live sensor or AI-model execution.",
            "checks": checks}


if __name__ == "__main__":
    print(json.dumps(run_example(), ensure_ascii=False, indent=2))
اعتبارسنجیِ کوچکِ ورودی حداکثر ۶۴ رکورد میگیرد؛ زمان از صفر تا یکمیلیون میلیثانیه و مقدار از منفی دههزار تا دههزار میلیولت است. شناسه دقیقاً A یا B است. زمانِ برابر مجاز و ترتیبِ ورودش حفظ میشود، اما کاهشِ زمان خطا دارد. bool، عددِ اعشاری، NaN، بینهایت، تعدادِ عضوِ اشتباه و مقدارِ بیرونِ دامنه رد میشوند. اینها قواعدِ همین درساند، نه محدودیتِ خودِ groupby.
تابعِ بررسیِ رکورد، تنبل است؛ خطای دیررس میتواند پس از مصرفِ ورودیهای قبلی دیده شود. snapshot_runs در آن حالت نتیجهٔ موفق برنمیگرداند، ولی اثرِ مصرفِ منبع را برنمیگرداند. قراردادِ تکرارگرِ پایتون نیز پیشروی و پایان را از بازخوانیِ دوباره جدا میکند. هیچ تراکنش، ثبتِ اتمی یا بازپخشِ زنده در این تابع وجود ندارد.
۴. مرجعِ دستی، مرتبسازی و ردِ مصرف
جمعِ صحیحِ مقادیرِ چهار گروه، بهترتیب ۲۰۱۰،۲۰۰۰،۱۹۷۰ و ۱۹۹۰ میلیولت است؛ اینها کنترلِ حسابیِ اعضای همان fixture هستند. جمع، اندازهگیریِ یک ولتاژِ فیزیکیِ مشترک، انتگرال یا میانگینِ زمانی نیست. مرجعِ دستی، همهٔ رکوردهای هر گروه را صریح دارد؛ تنها برابرشدنِ چهار جمع کافی نیست، چون جابهجاییِ بعضی اعضا ممکن است جمع را حفظ کند.
{
  "python_version": "3.14.5",
  "profile": "synthetic records(timestamp_ms, sensorAorB, voltage_mV), max64, integer bounded quantities, nondecreasing time, input order preserved; no I/O or sorting in snapshot_runs",
  "consecutive_run_keys": [
    "A",
    "B",
    "A",
    "B"
  ],
  "consecutive_run_sizes": [
    2,
    1,
    2,
    1
  ],
  "run_sums_mv": [
    2010,
    2000,
    1970,
    1990
  ],
  "sorted_sensor_timestamp_order_ms": [
    0,
    1,
    3,
    4,
    2,
    5
  ],
  "old_group_after_outer_advance": [],
  "dictionary_retained_records": 3,
  "independent_reference_sequences_one_group": 63,
  "limitations": "Materialized groups retain this bounded fixture; no constant-memory/speed claim. Shared group iterators are not independent snapshots; sorting by sensor changes global time order. A late validation failure does not rewind source effects; no transaction, live sensor or AI-model execution.",
  "checks": {
    "four_consecutive_runs_match_independent_literal_rows": true,
    "nonadjacent_same_sensor_does_not_become_one_run": true,
    "run_sizes_and_integer_mv_sums_are_hand_values": true,
    "constructing_groupby_does_not_pull_this_generator": true,
    "outer_advance_discards_unconsumed_old_group": true,
    "next_group_retains_its_first_boundary_record": true,
    "storing_raw_group_iterators_does_not_snapshot_them": true,
    "materialized_immutable_group_survives_outer_advance": true,
    "bounded_known_source_read_once_and_then_exhausted": true,
    "stable_sensor_sort_merges_keys_but_changes_chronology": true,
    "dict_of_runs_overwrites_earlier_repeated_key": true,
    "empty_singleton_all_same_and_equal_timestamp_order": true,
    "63_adjacent_boundary_reference_sequences_one_group": true,
    "types_ranges_and_three_field_unit_profile_rejected": true,
    "64_record_cap_and_65th_rejection": true,
    "late_validation_error_does_not_undo_source_consumption": true
  }
}
مرجعِ مستقلِ دیگر، جایگاههای شروعِ گروه را با مقایسهٔ کلیدِ دو عضوِ مجاور پیدا میکند و برشِ موردِ انتظار میسازد؛ از groupby و تابعِ اصلی استفاده نمیکند. شصتوسه دنبالهٔ کوچکِ کلید، از طولِ صفر تا پنج، با آن سنجیده میشوند و یک گروهِ بررسیاند. بازکردنِ همهٔ گروههای خروجی نیز باید دقیقاً ترتیبِ ورودی را بازسازی کند؛ تکرار یا حذفِ رکورد مجاز نیست.
اگر داده را بر اساسِ حسگر مرتب کنیم، تمامِ Aها و Bها کنار هم میآیند؛ گروهها اکنون چهار و دو عضو دارند. در این شاهد، ترتیبِ نسبیِ اعضای هر حسگر حفظ میشود، اما ترتیبِ زمانِ کل به صفر، یک، سه، چهار، دو، پنج تغییر میکند. این نمایش با groupby خام ساخته شده است؛ تابعِ خودمان که زمانِ کاهشی را نمیپذیرد، همان ورودیِ مرتبشده را رد میکند. مرتبسازی پاسخِ پرسشِ دیگری است.
یک اشتباهِ جدا، ساختنِ dict از گروههای پیاپی است: کلیدِ A و B تکرار میشود و گروهِ آخرِ هرکدام جایِ قبلی را میگیرد. در نتیجه تنها سه رکورد میمانند، نه شش. این تبدیل، تجمیعِ سراسری نیست. در مقابل، منبعِ مولدِ دارایِ ردِ مصرف، هنگامِ ساختن هنوز چیزی تحویل نداده و پس از مصرفِ کامل، هر شش جایگاه را یکبار نشان میدهد؛ گذرِ دوم روی همان شیء تهی است.
شانزده گروهِ بررسی با Python 3.14.5 اجرا شده و منابعِ 3.14.8 در ۲۵ مهر ۱۴۰۵ خوانده شدهاند؛ مرجعِ عبارتِ مولد تفاوتِ ساختِ تکرارگر و تولیدِ تنبلِ مقدار را توضیح میدهد. این برنامه عمداً تمامِ گروههای محدود را نگه میدارد و ادعای حافظهٔ ثابت ندارد. دستهبندیِ مولدِ حسگر اندازهٔ دسته را میسنجید؛ اعتبارسنجیِ رکوردِ حسگر هم مسئولیتِ محتوای داده را جدا روشن میکند.
۵. چهار پرسش با پاسخِ کامل
پرسش اول: دنبالهٔ A،A،B،A،A،B چند گروه دارد؟ پاسخ: چهار گروهِ پیاپی با طولهای دو، یک، دو و یک. بازگشتِ A پس از B، گروهِ تازه است و خودکار به ابتدای داده ملحق نمیشود.
پرسش دوم: پس از خواندنِ یک عضو از گروهِ اول و پیشرویِ بیرونی چه میشود؟ پاسخ: باقیماندهٔ گروهِ قبلی دیگر از تکرارگرِ قدیمی قابلمصرف نیست. نخستین عضوِ گروهِ جدید در گروهِ جدید حاضر است؛ برای نگهداریِ قبلی باید پیش از پیشروی آن را مصرف و ذخیره کرد.
پرسش سوم: مرتبسازیِ حسگر ترتیبِ زمان را حفظ میکند؟ پاسخ: در این fixture ترتیبِ کل تغییر میکند؛ زمانِ دو پس از چهار میآید. مرتبسازی برای گروهبندیِ سراسری میتواند مناسب باشد، اما نباید آن را همان مسیرِ زمانیِ اولیه معرفی کرد.
پرسش چهارم: dict گروههای این مثال چند رکورد نگه میدارد؟ پاسخ: سه؛ گروهِ آخرِ A دو عضو و گروهِ آخرِ B یک عضو دارند. بازنویسیِ کلیدهای تکراری، دو گروهِ قبلی را حذف میکند؛ برای نگهداریِ همهٔ اجراهای پیاپی، فهرست یا tuple گروهها لازم است.
منابع و مطالعهٔ بیشتر
- Python itertools.groupby؛ گروه پیاپی و تکرارگر مشترک
- Python؛ قرارداد تکرارگر و پایان مصرف
- Python؛ عبارت مولد و ارزیابی تنبل
بررسی منابع: ۲۵ مهر ۱۴۰۵. تحلیلها و پیشنهادهای اجرایی، جمعبندی نویسندهاند.